_20261104104904164.png)
AI가 쓴 광고 문구는 왜 다 비슷할까

- 한눈에 보는 핵심요약
- AI가 쓴 광고 문구가 평범해지는 이유를 데이터 결핍에서 짚고, 광고 기록과 고객 언어를 한곳에 모으는 방법을 정리했습니다.
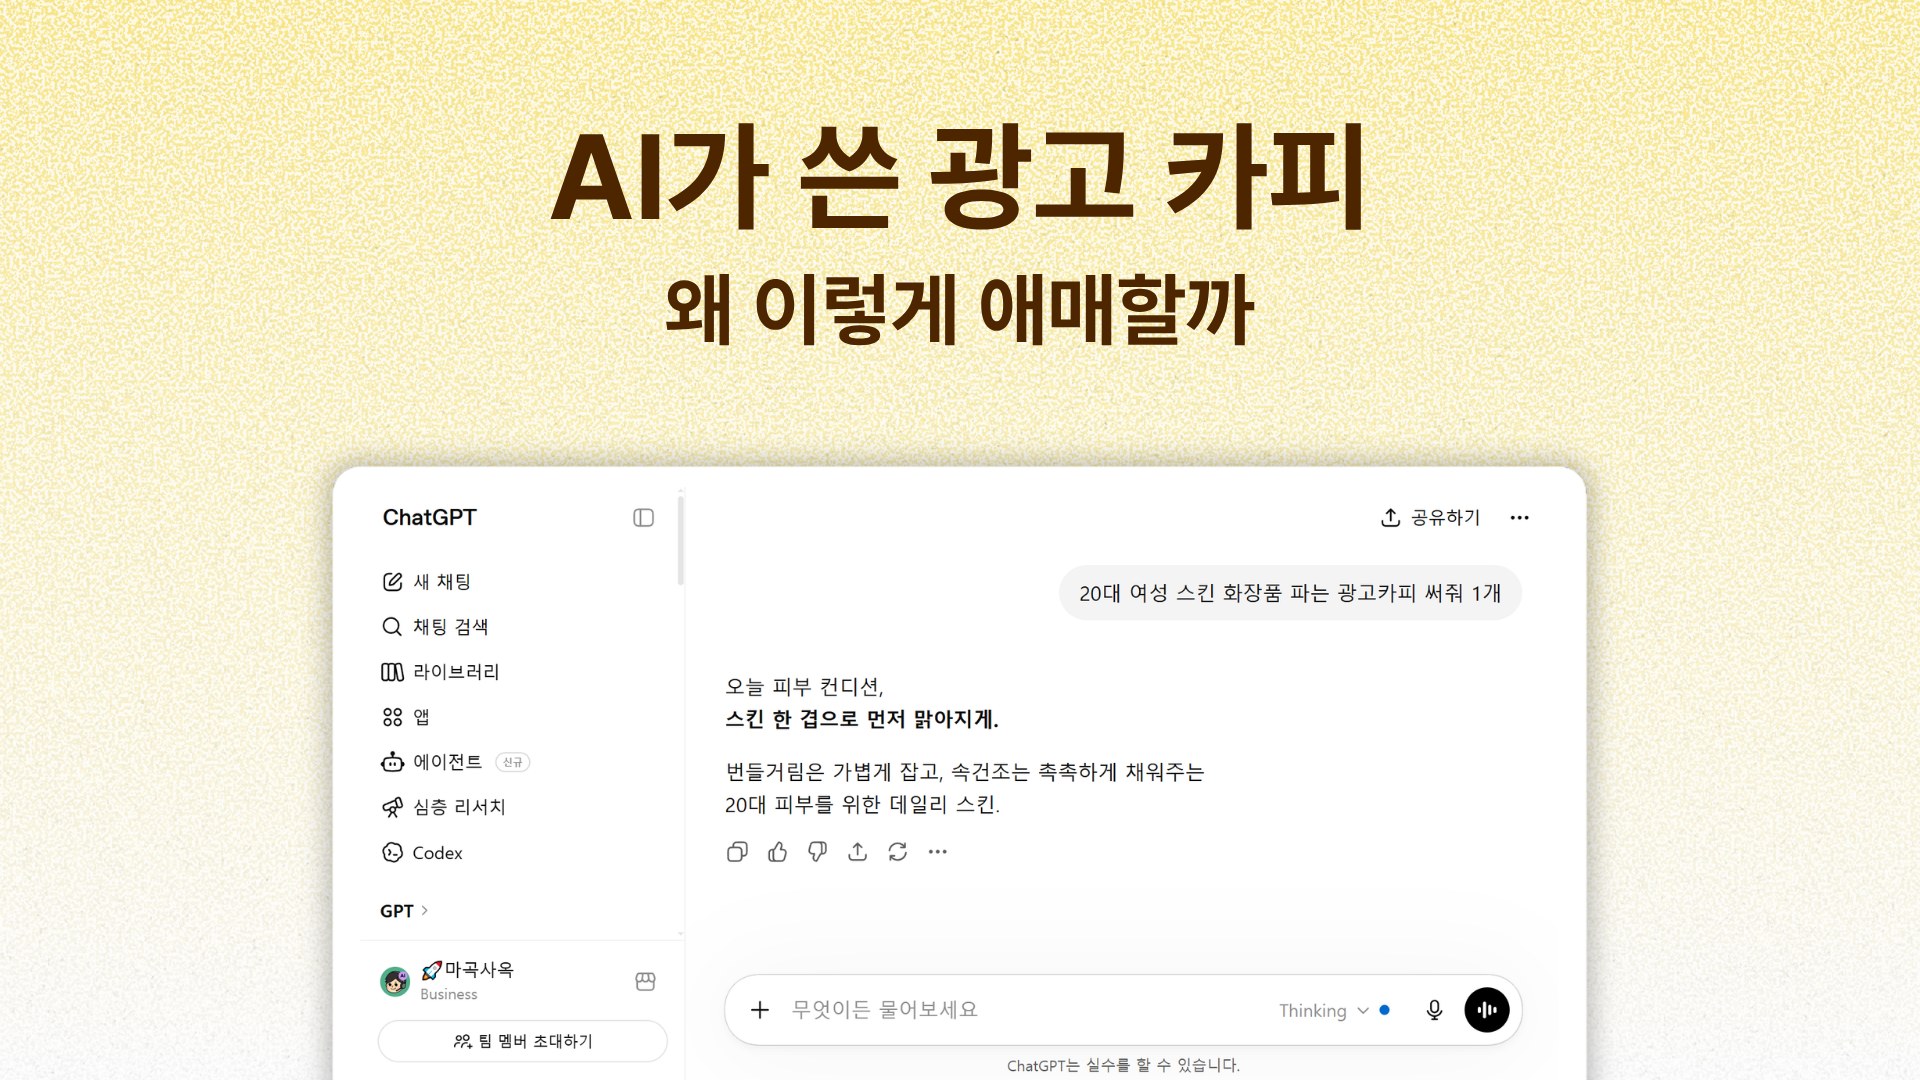
ChatGPT에 광고 문구를 요청해 본 마케터라면 이 장면이 익숙할 것입니다.
“이 제품 광고 문구 5개만 써줘.”
답은 몇 초 만에 나옵니다. 얼핏 그럴듯합니다. 그런데 그대로 집행할 수 있는 문장은 없습니다. 틀린 데는 없는데 제품만의 결이 안 보이고, 고객이 실제로 쓰는 표현과도 미묘하게 어긋납니다. 타깃을 설명하고 특징을 붙이고 톤을 지정해도 결과는 비슷합니다. 문장은 나오는데 광고에 얹을 만큼 뾰족하지 않습니다.
이때 흔한 결론은 셋입니다. “AI가 생각보다 광고 카피는 잘 못 쓰네.” “프롬프트를 더 잘 써야 하나?” “결국 사람이 다시 고쳐야 하는 거 아닌가?” 셋 다 과녁을 빗나간 진단일 가능성이 큽니다. 원인은 AI의 문장력이 아니라, AI가 참조할 광고 이력·고객 언어·상품 맥락이 어디에도 정리돼 있지 않다는 데 있습니다.
정의: ‘애매한 AI 카피’는 데이터 결핍의 증상이다
준비 없이 AI를 붙이면 속도가 나는 게 아니라 검토 업무만 늡니다. 초안은 빨리 나오지만, 그 초안이 자사에 맞는지 가려내고 고치는 데 더 긴 시간이 들기 때문입니다. 손으로 썼으면 10분에 끝났을 카피를, AI에 브리핑하고 출력물을 점검하고 재수정을 시키느라 1시간씩 붙잡는 일이 생깁니다.
이런 경험이 반복되면 실무자는 AI를 덜 쓰게 되고, 구독료만 매달 빠져나갑니다. ‘애매한 카피’는 도구의 결함이 아니라, 참조 데이터가 비어 있다는 신호로 읽어야 합니다.
근거: 맥락이 없으면 AI는 평균값으로 수렴한다
AI는 근거가 빈약할수록 안전하고 평균적인 답으로 기우는 도구입니다. 배경 없이 “이 제품 광고 카피 5개 써줘”라고 하면 AI에게 그 제품은 초면입니다. 구매자가 누구인지, 출시 의도가 뭔지, 성과가 좋았던 문구의 톤은 어땠는지, 실패한 소재의 공통점은 뭔지 알 길이 없습니다. 그래서 세상에 널린 광고 어휘로 빈칸을 메웁니다. “지금 바로 만나보세요”, “특별한 경험을 선사합니다” 같은 문장이 나오는 배경입니다.
실무 환경을 점검해 보면 원인이 더 분명해집니다. 집행 성과는 메타 광고 관리자와 네이버 광고센터에, 고객 후기는 자사몰과 네이버 스마트스토어에, 기획안은 개인 PC와 구글 드라이브와 메일함에, 회의에서 정한 톤앤매너는 카톡방의 30줄짜리 메시지 속에 흩어져 있습니다. 이 상태에서 AI가 읽을 수 있는 회사 데이터는 사실상 없습니다. AI가 밋밋한 문장을 내놓는 건 지능이 모자라서가 아니라, 읽을 자료를 정돈된 형태로 받은 적이 없어서입니다.
예시: 광고 기록과 고객 언어를 한곳에 모은 워크플로우
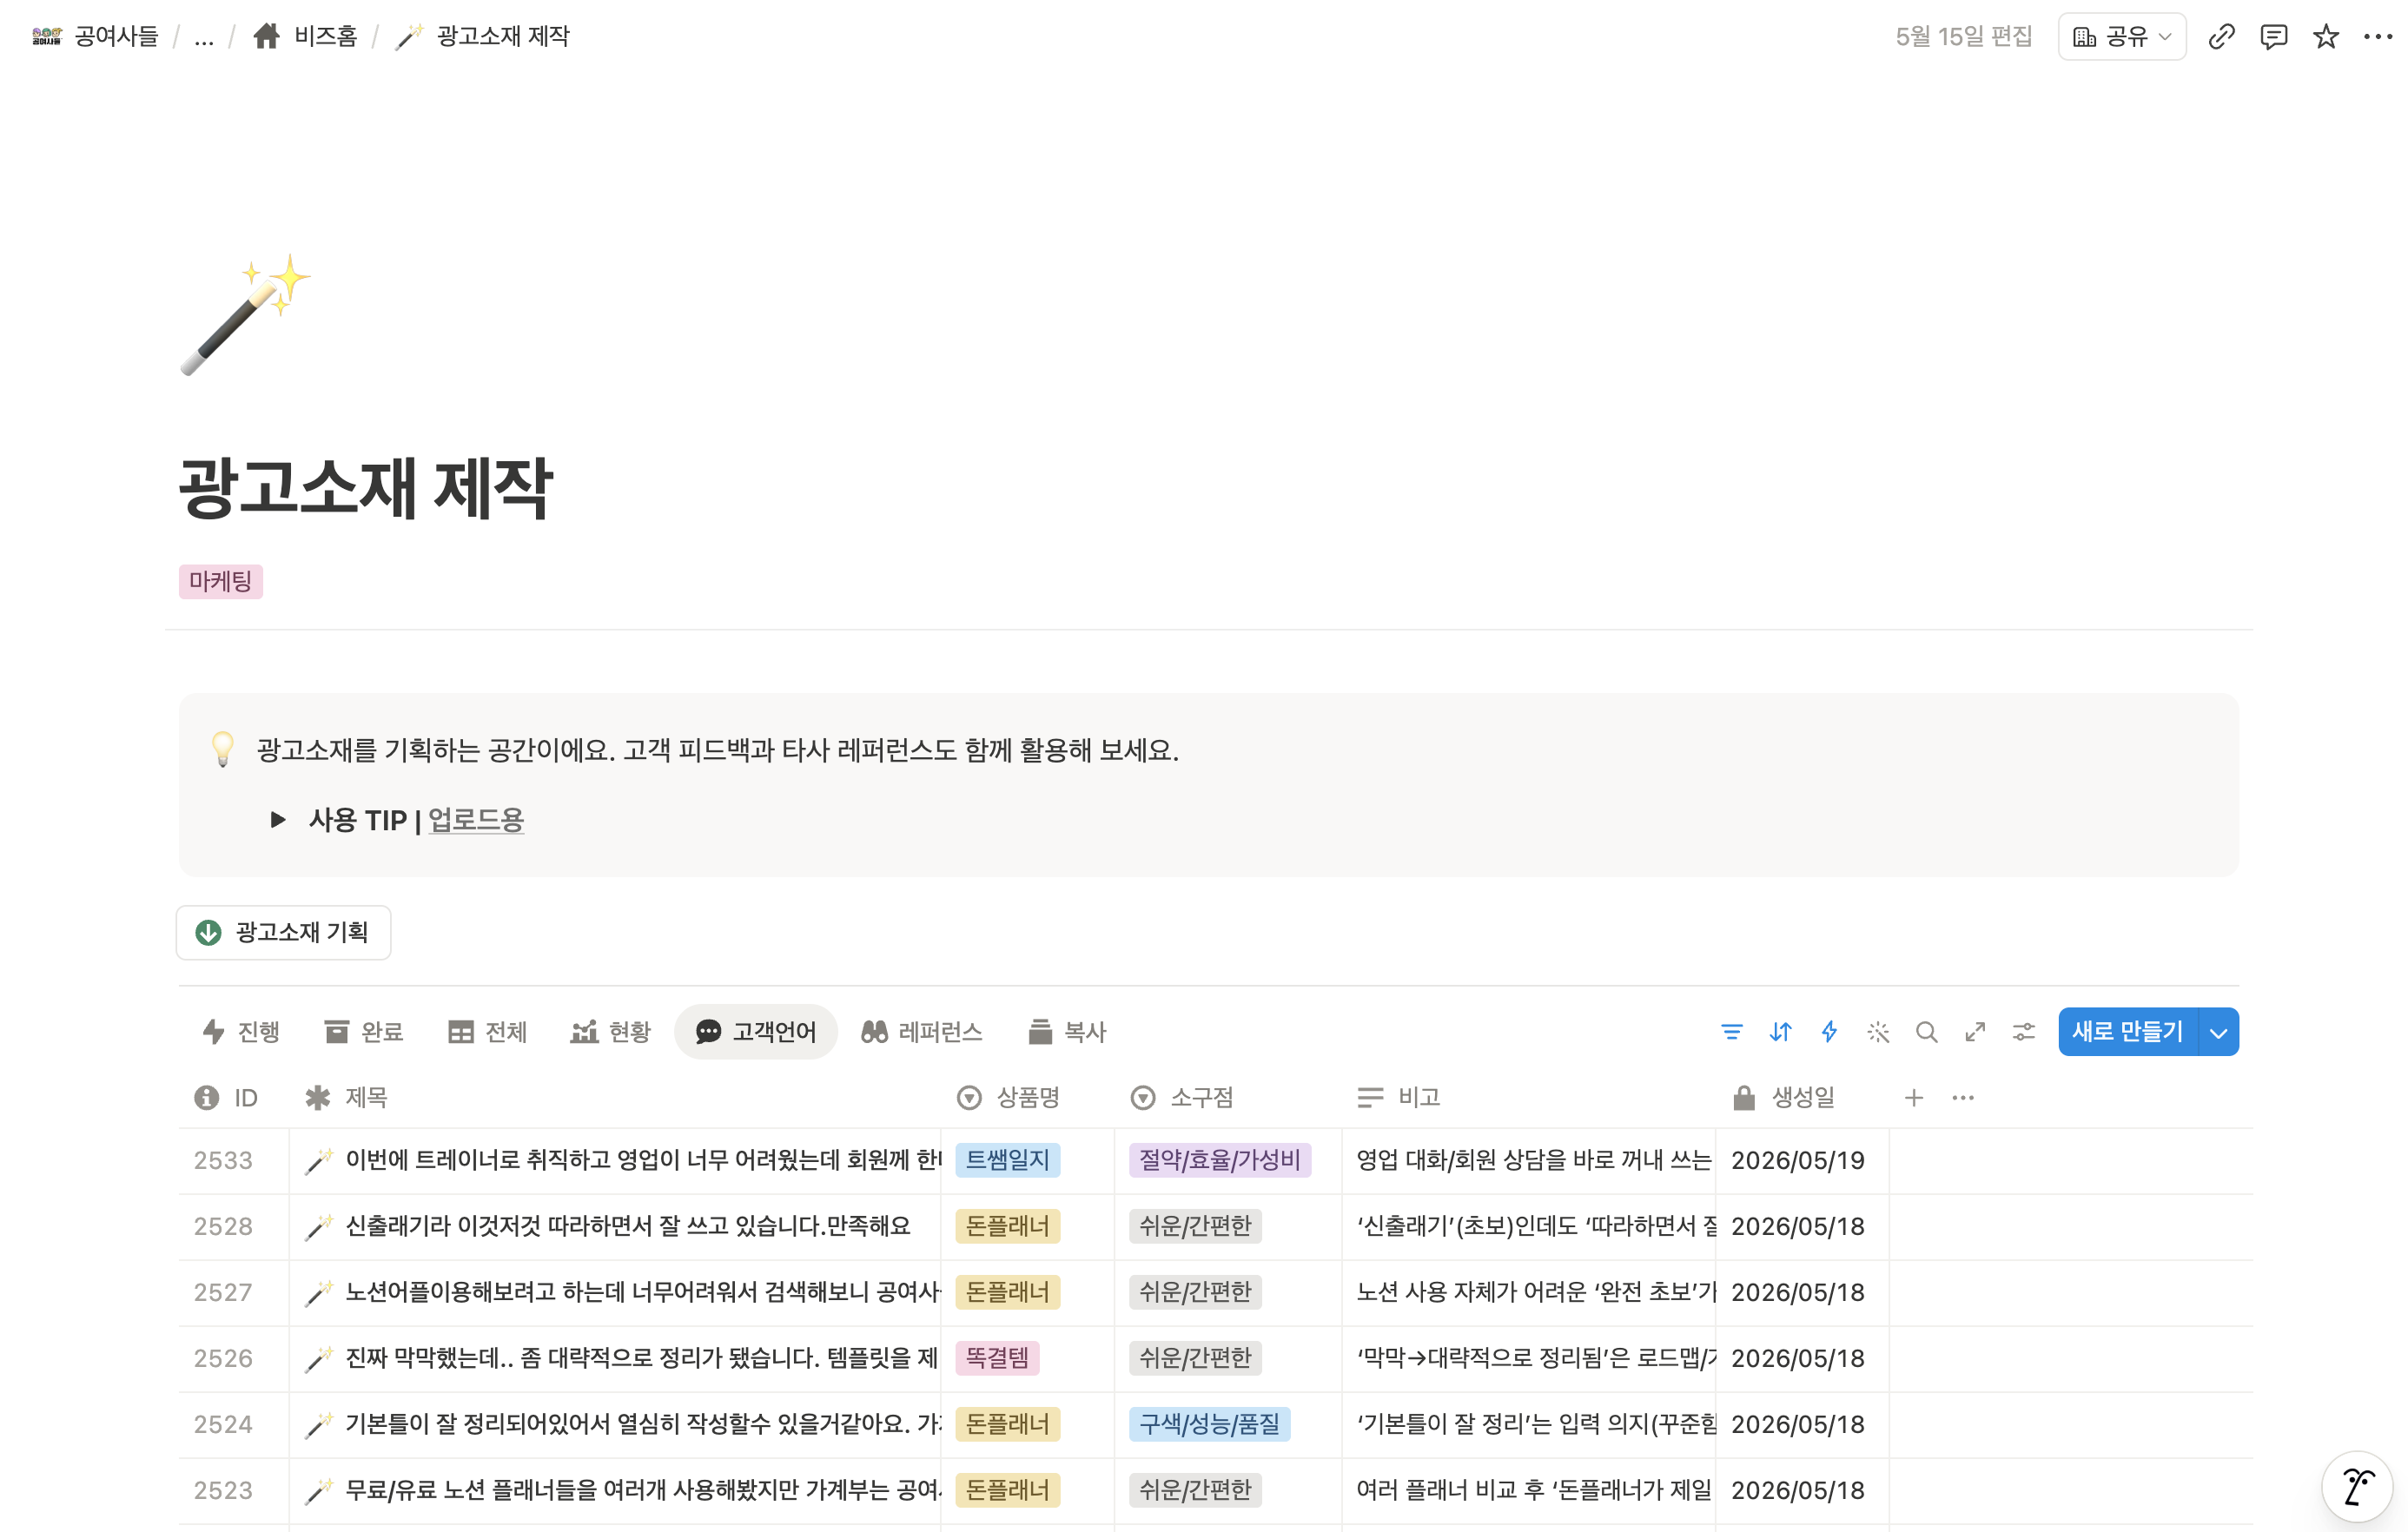
노션처럼 텍스트 기반으로 기록이 쌓이는 협업 도구를 쓰는 팀의 사례를 보겠습니다. 1단계로 광고소재 데이터베이스를 만들고, 매주 메타와 네이버에 집행한 소재, 구매 전환, 성패 평가를 한 줄씩 적립합니다.
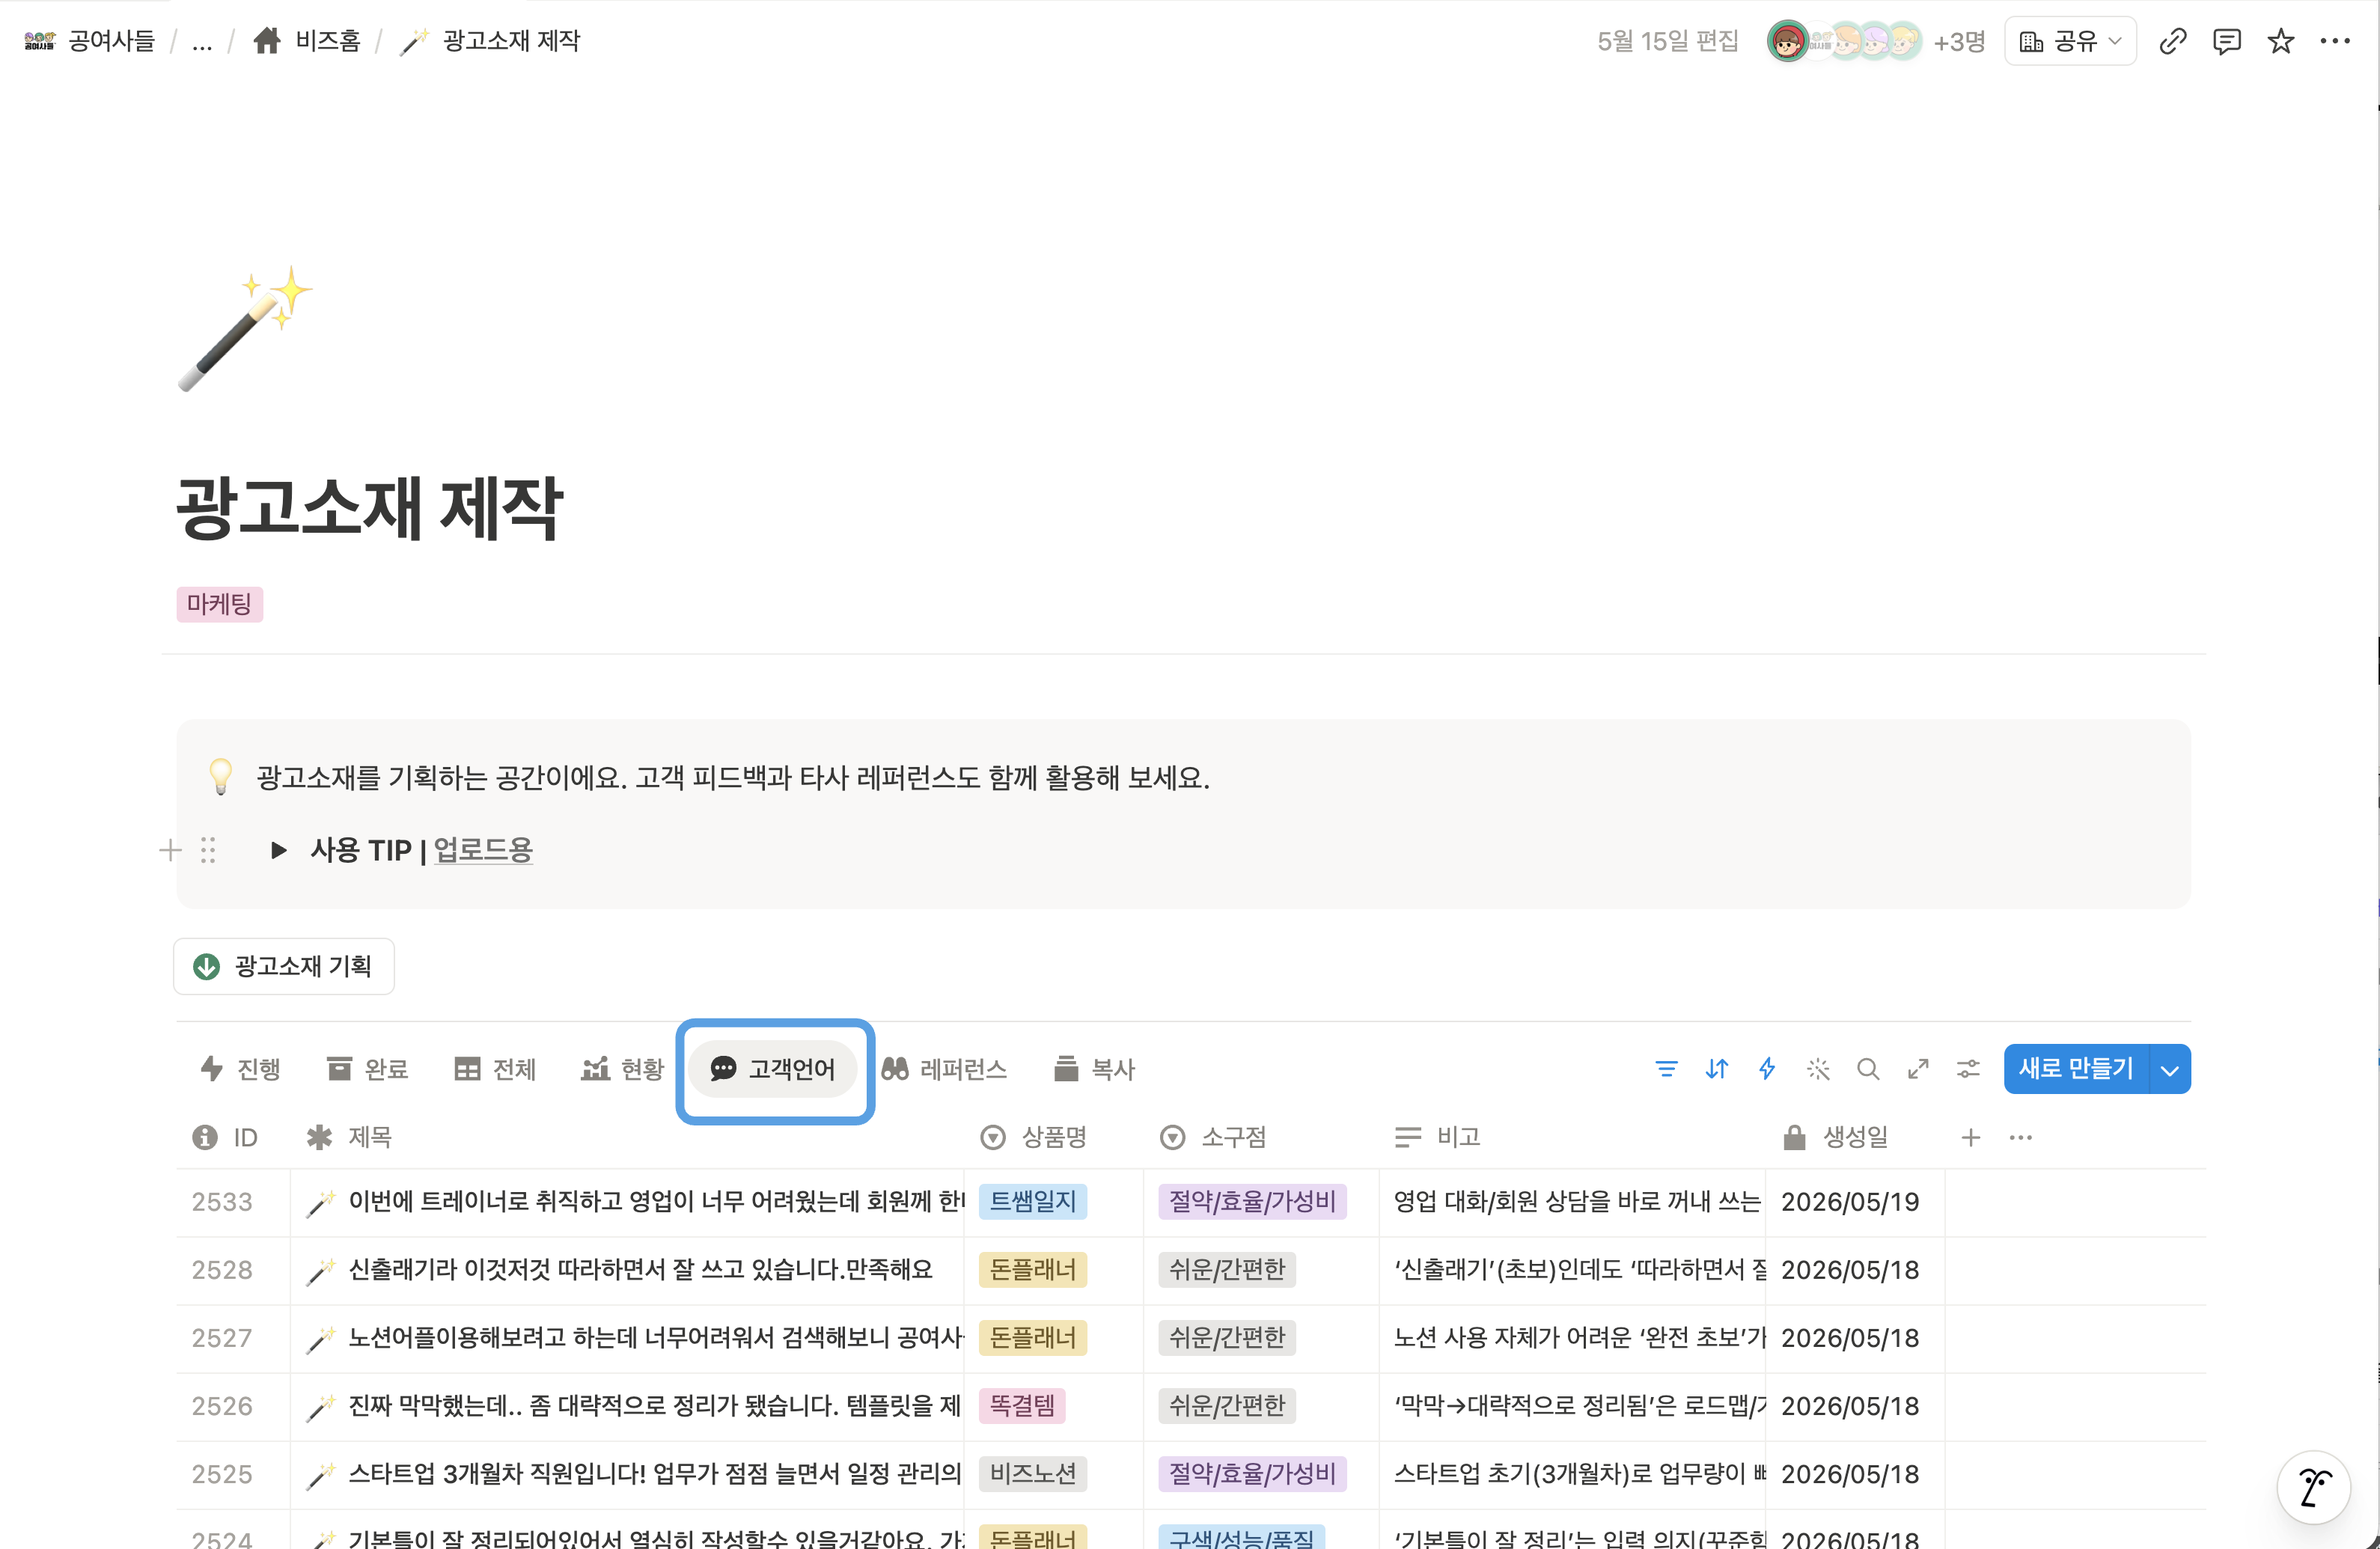
고객 언어 탭도 함께 만들어 자사몰 후기, 인스타 댓글, 카톡 상담에 남은 표현을 원문 그대로 옮깁니다. 3개월이면 AI가 참조할 재료가 몇백 개 규모로 쌓입니다.
2단계로 이 두 데이터를 참조하는 “메타광고 소재 카피 생성기”라는 스킬을 만듭니다. 어느 DB를 볼지, 어떤 톤을 쓸지, 어떤 후킹 패턴을 우선할지를 스킬에 명시해 두면, 담당자가 바뀌거나 신상품이 나와도 같은 방식으로 작동합니다. 이후 마케터는 “@메타광고 소재 카피 생성기 신규 캠페인용 카피 10개 뽑아줘” 한 줄만 입력하면 됩니다. AI는 성과가 좋았던 카피 구조를 참고하고, 실제 고객의 표현을 가져오고, 실패한 소재의 패턴은 걸러가며 10개를 내놓습니다. 같은 AI인데 산출물이 달라지는 이유는 회사의 실측 데이터 위에서 만들어졌기 때문입니다.
도입 전후의 차이는 수치로 갈립니다. 이전에는 카피 10개 산출에 평균 3시간이 걸렸고, 통했던 구조는 담당자 머릿속에만 있었으며, 고객 언어를 보려면 후기 페이지 50개를 손수 스크롤해야 했습니다. 이후에는 초안 10개가 1분 안에 나오고 사람은 검수만 하며, 3개월 전 실적과 1년 전 캠페인 패턴까지 자동 반영되고, 성공작과 실패작의 차이가 회사 자산으로 남습니다.
실행 팁: 피드백 루프까지 설계해야 완성이다
- 첫째, 자료를 흩어두지 말 것. 광고 성과·고객 언어·기획 의도가 각기 다른 도구에 있으면 AI는 아무것도 읽지 못합니다. 기록이 텍스트로 남고 문서끼리 연결되는 공간 하나를 정해 그곳에서 일해야 합니다.
- 둘째, 고객의 말은 원문 그대로 수집할 것. 요약하거나 다듬는 순간 카피의 재료로서 가치가 줄어듭니다.
- 셋째, 집행 결과를 다시 입력값으로 되돌릴 것. 어떤 문구가 클릭을 만들었는지, 어떤 표현이 구매로 이어졌는지, 반응 대비 전환이 낮았던 소재는 무엇인지가 환류돼야 다음 카피의 수준이 오릅니다. 후기와 상품 정보만 쌓으면 AI는 매번 비슷한 확률의 신작을 던질 뿐이지만, 성적표를 함께 읽히면 자사에서 검증된 패턴을 기준으로 뽑기 시작합니다.
정리하면, 광고 카피 AI의 품질은 프롬프트 기술이 아니라 회사 데이터의 축적량이 정합니다. 자료 없이 결제한 AI는 운에 맡기는 도구지만, 광고 실적과 고객 언어가 매주 쌓이는 구조 위의 AI는 다른 회사가 따라 하기 어려운 전용 자산이 됩니다. 오늘 데이터가 쌓일 자리부터 만들면, 3개월 뒤의 AI는 전혀 다른 문장을 쓰기 시작합니다.
gongysd.com ⓒ공여사들, '일의 구조'를 만듭니다.
_20261104141047336.png)
추천 콘텐츠
관련 콘텐츠가 없습니다.
